拉高 Claude 的 effort,也就是深度思考档位,能少掉一些测试没覆盖、边角没处理好的问题。但按我的归类,理解类错误加在一起几乎不动,所以不要靠拉满档位纠正误解。
Thariq Shihipar 在 claude.dev 公开过一组数据:拉高档位,往往能少这类查验上的疏漏,却修不好走错的路线。理解类几乎没动,是我把他报告的失败类型,在 low 和 max 两边用同一套规则加总后看到的,不是原文现成的两栏。这和我自己碰到的情况一致:方向没问清,档位开到 max 也会听岔。
所以更管用的顺序是,先把方向问清,再按任务选模型和档位。日常默认 medium,检查和验收再单独把档位抬高。
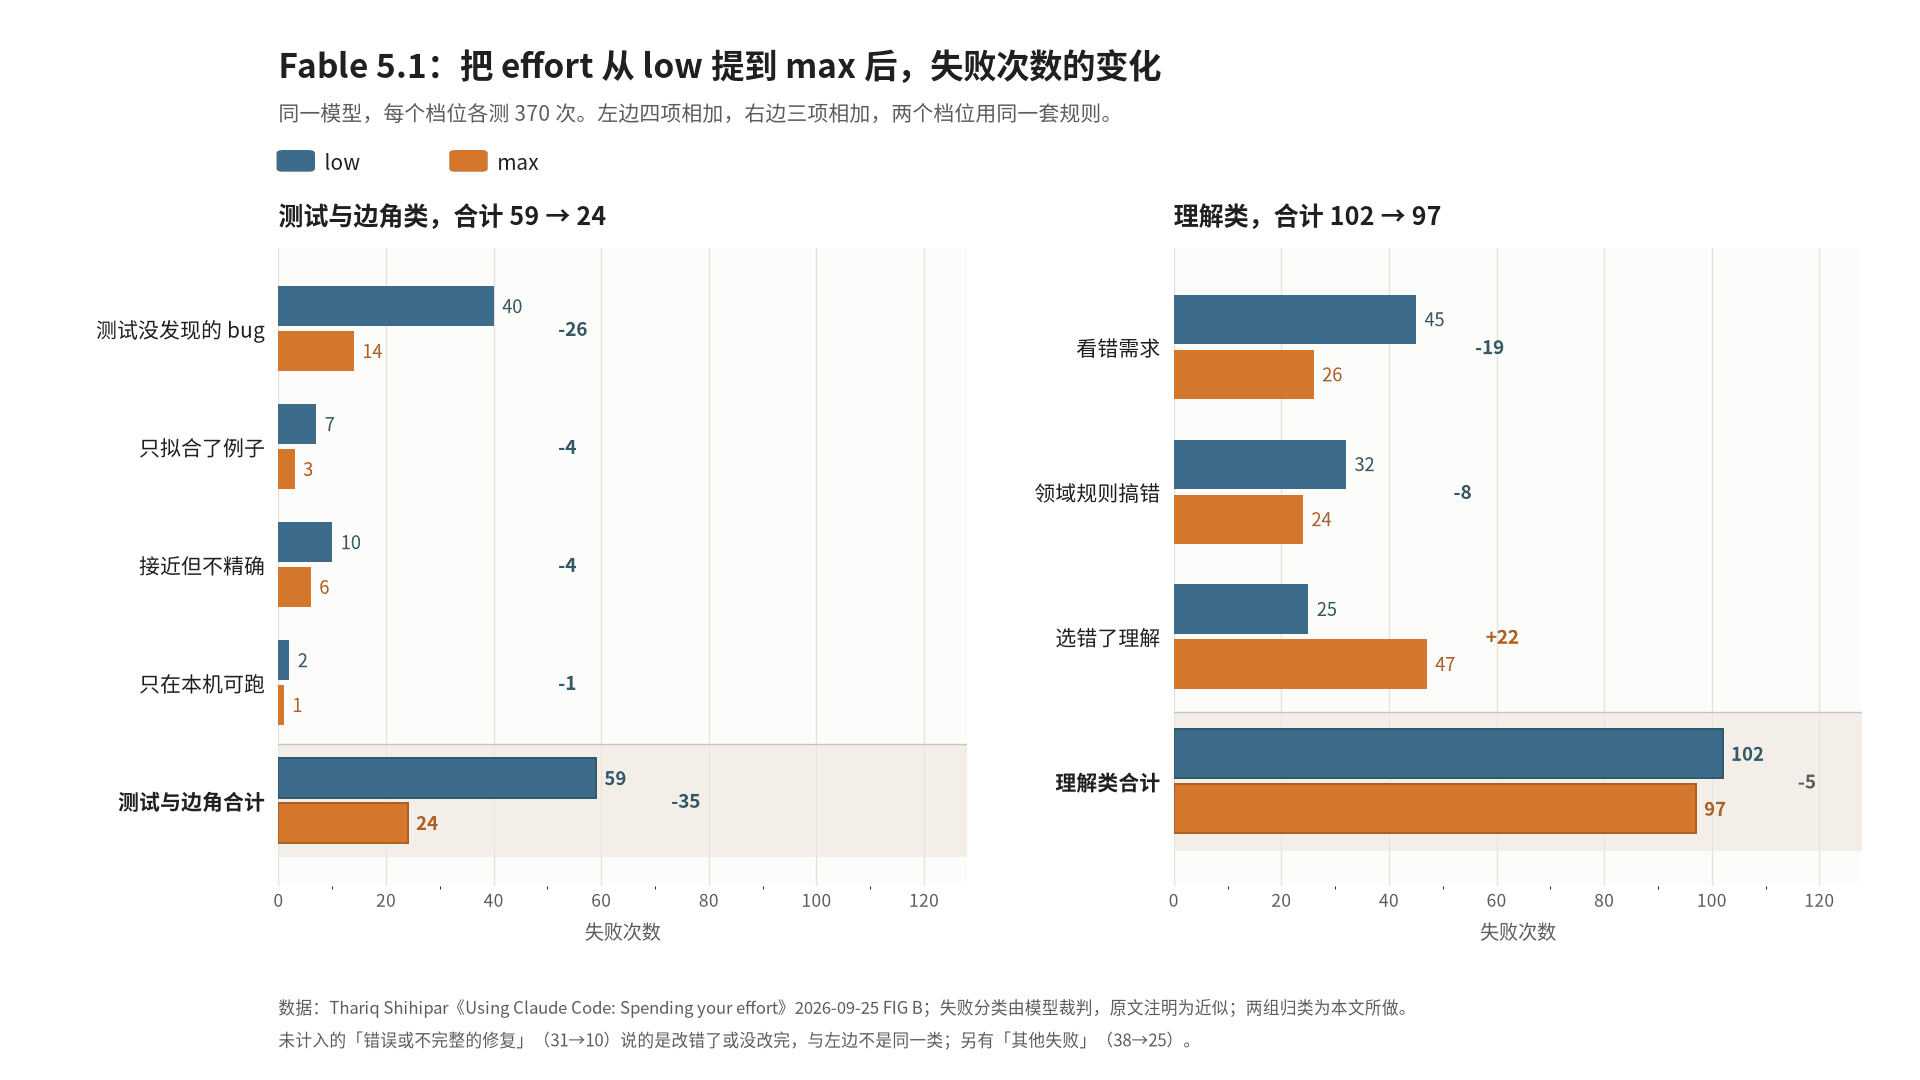
数据:从 low 到 max,测试与边角类 59→24,理解类 102→97
拉高档位以后,两类失败的数字怎么变?
档位拉高,模型还是同一个。变的是它查得多不多、验得细不细、替你做多少判断。Thariq 的说法是,effort 调节验证和边角测试的量,以及模型用自己判断的多少。文档还写过,低档会接受一定的能力折扣。
他在 2026 年 9 月 25 日那篇《Using Claude Code: Spending your effort》里,公布了一组叫 Fable 5.1 的内部评测:同一模型从 low 到 max,各 370 次尝试,记录失败分类。分类由模型裁判,原文写明是近似。分项是他报告的;我把其中两类分别加总,两边用的是同一套规则,所以不是原文现成的两栏,也不是 Claude 团队原表。
测试没覆盖、边角没处理好这类问题,四项加在一起,从 59 次降到 24 次。其中「测试没发现的 bug」从 40 降到 14,其余是只拟合了例子、接近但不精确、只在本机可跑。
我没有把「错误或不完整的修复」算进来。它说的是改错了或没改完,不是测试没覆盖,自己也从 31 降到 10。两组都在降,但不是同一类问题。还有「其他失败」从 38 降到 25,同样单列。
理解类三项加在一起,从 102 次到 97 次,几乎没动。但分项并不往同一个方向走。「选错了理解」从 25 升到 47,也就是把事情理解成了另一条路;「看错需求」从 45 降到 26,几乎少了一半;「领域规则搞错」从 32 降到 24。所以我说「几乎不动」,指的是这三类加在一起,并不能据此以为拉高档位对「看错需求」也没用。升上去的是走错路这种,这和 Thariq 的判断仍然对得上:拉高档位往往能减少查验上的疏漏,却修不好走错的路线。
同一组实验里,做成的次数从 140 升到 214。多换来的,主要是更全的查验,以及更多做完的活。它没有自动把理解类错误压下去。
Thariq 还写过一个规格不完整的小例子:低档大约 1.5 分钟,max 用了 67 分钟,并且多出了一张热力图。规格不完整时,拉高档位会让成品更完整,同时模型会多做选择。低档适合当迭代的起点;若你就是要它一次给出更完整的一版,max 仍然用得上,只是会更慢,也会替你多拿主意。
如果只看上升的那一类理解错误,会把情况看成「漏的少了、歪的多了」。我没有只取这一项。
先问清楚,再动手
方向还没问清时,为什么不能靠拉高档位纠正?因为缺口还在你脑子里时,模型只会补假设。档位拉到 max,也一样。
Thariq 给自己写的循环,第一步就是把规格交给 Claude,让它先访谈你,把你漏说的细节问出来。我常用的是 Matt Pocock 的 grill-me,以及会读代码库的 grill-with-docs。
grill-me 的文档里写过,一路只回同意,会得到看起来很笃定的胡说。Thariq 则写过,档位越高,Claude 越会替你多做假设。这两件事常常一起出现,但我并不认为其中一个导致了另一个。
方向没说清的情况,我这边很多时候都有,所以经常先 grill,把没说清的地方问完再动手。
2026 年 8 月 31 日那次,effort 已经是 max。我要的是按一种通用发布方式,把一套做法收成可分享的技能。它却听成了要仿做我先前发布过的一个叫 research pro 的项目,跑了 60 次工具调用,我才拦住。
我说的是:「我不是说要效仿 research pro 我只是说希望能 generic 给大家分享」。它把需求听成了另一件事。这一次说明的是:方向没问清时,档位拉满也会听岔。它不能证明,先 grill 就一定能避免这次误读。
按任务选模型和档位
方向定了以后,模型和档位该怎么选?同一任务可以换档,默认不必开到 max。模型和思考深度按活指定,不必固定在一档。
Thariq 的经验是,大多数日常开发用 medium;他另有一套循环:先访谈,再用低档实现,最后用高档做验证和测试。我自己的默认也接近「日常用 medium」:我这边给 Claude Opus 5.5 的默认是 medium,high 只留给特别严重的问题,而且要先问过我再开。这是我的用法,不是他把规矩定给我。
按活指定,不必改全局默认。2026 年 9 月 24 日,我让另一个模型来想方案,说:「帮我用 mimo 2.6 pro high thinking 思考这个问题 帮我 delegate task 不要改 config」。这里的 thinking,是那个模型上类似 effort 的档位,不是 Claude 的 effort。验收也可以单独抬一档:2026 年 8 月 26 日,我把 Claude 的 /effort max 留给检查,并要求再分头验一轮。
所以我习惯这样分:方向还没确认时,用低档或中档;需要推敲方案,可以临时指定更高的思考深度,但不去改默认;到了检查和验收,再单独抬高,必要时开到 max。
拉开差距的是上下文和抬档时机
不把档位拉满的话,真正管用的是什么?同样不把档位拉满时,人和人之间拉开差距的,是你带来的上下文,以及你何时抬档。
前面的数据和 8 月 31 日那次都指向这件事:方向没讲清,多想一轮也补不上。
这不是说高档没用。规格已经问清楚,或者你就是要它一次做完、少在中间停下来问你,高档仍然用得上。只是不要指望单靠抬档,把没问清的方向补上。
参考资料
- Thariq Shihipar,Using Claude Code: Spending your effort,2026-09-25:effort 用法、Fable 5.1 失败分类,以及他先访谈、再用低档实现、最后用高档验证的循环
- Claude Effort 文档:档位在细致程度和 token 效率之间权衡,低档可能有能力折扣,Opus 5.5 默认 medium
- Matt Pocock,grill-me 文档:先访谈、把计划问清楚的现成方法
- Inverse Scaling in Test-Time Compute,arXiv:2507.14417:加长推理不总是更准。这是另一条证据线,不是文中这张图的支撑
文中 Fable 5.1 的分项数字来自 Thariq 2026 年 9 月 25 日文里的 FIG B,各档 370 次,失败分类由模型裁判,原文写明为近似。测试与边角类 59→24、理解类 102→97 是我按同一套规则合计的,不是原文现成的两栏,也不是我自己跑出来的实测。「错误或不完整的修复」31→10、「其他失败」38→25 没有计入这两组,上文已经说明原因。
8 月 31 日、9 月 24 日、8 月 26 日的例子是我的亲身经历,对公开场合做了简化。先问清再动手、按任务选档,以及何时抬档的判断,是做法建议。参考资料里的 Inverse Scaling 是另一条公开证据线,正文没有展开,也不是这张图的依据。